
8CiberBleepingComputer ·
Pillow, la librería de imágenes más utilizada para Python, contiene múltiples vulnerabilidades críticas que permiten ejecutar código arbitrario a través de ficheros manipulados. El fallo principal (CVE-2026-112900) afecta al manejo de imágenes EPS, donde la librería pasa el nombre del fichero a Ghostscript sin validación previa. Pillow se descarga aproximadamente 436 millones de veces al mes y está presente en aplicaciones web, herramientas de avatar, tuberías de PDF y proyectos de aprendizaje automático, por lo que el riesgo es generalizado.
→ Actualiza Pillow a versión 13.0.0 o posterior ejecutando pip install -U 'Pillow>=13.0.0' y reconstruye contenedores o imágenes base.
El proyecto LiteLLM sufrió un ataque a su cadena de suministro: atacantes comprometieron el pipeline de lanzamientos y distribuyeron la versión 1.107.0 en PyPI y Docker Hub con malware que roba credenciales, secretos y variables de entorno. LiteLLM es una SDK de Python masivamente popular (92 millones de descargas mensuales, 61.800 estrellas en GitHub) utilizada por empresas como NVIDIA, Netflix, AT&T y Okta, lo que convierte este incidente en un riesgo crítico para miles de aplicaciones en producción.
eMudhra, una autoridad de certificación india, abandona su negocio global de certificados SSL/TLS tras descubrirse que ocho claves privadas de certificados intermedios eran fácilmente adivinables (todos los valores estaban por debajo de 256). Chrome y Firefox han dejado de confiar en la raíz emSign ECC Root CA - G3, afectando a unos 30.800 certificados sin expirar, principalmente de InCommon utilizado por universidades estadounidenses. eMudhra reemplazará los certificados afectados con otros gratuitos de socios, y la empresa estima que el 97% de los 30.000 certificados afectados pueden migrarse automáticamente mediante ACME.
Arista Networks ha parcheado una vulnerabilidad zero-day crítica en VeloCloud Orchestrator (VCO) On-Prem que está siendo explotada activamente. El fallo (CVE-2026-114625) permite a atacantes con credenciales válidas y acceso a la interfaz web escalar privilegios mediante SQL injection, comprometiendo la confidencialidad, integridad y disponibilidad del orquestador. La empresa ha publicado parches para sus despliegues alojados y recomienda restricciones de acceso inmediatas.
→ Actualiza VeloCloud Orchestrator a versión 5.2.3.18 o posterior, 6.1.3.10 o posterior, o 6.4.2.12 o posterior, y restringe el acceso a la interfaz web a redes administrativas hasta completar el parche.
Se han revelado públicamente dos vulnerabilidades de ejecución remota de código (RCE) críticas en KSMBD, el servidor SMB integrado del kernel de Linux, ambas con puntuación CVSS 9.0, sin que existan parches en el kernel principal. Una de ellas (ZDI-CAN-33774) no requiere autenticación previa y afecta a cualquier servidor KSMBD en el puerto 445; la otra (ZDI-CAN-33549) requiere una interfaz compatible con RDMA. Las vulnerabilidades fueron divulgadas en listas de correo públicas antes de que estuviesen disponibles correcciones, incumpliendo las prácticas de divulgación responsable del proyecto kernel de Linux.



→ Rota inmediatamente todas las variables de entorno, claves API, credenciales de base de datos y credenciales de registro privado almacenadas en Railway.



Investigadores evalúan un planificador inspirado en la neurobiología de las moscas Drosophila para mejorar agentes autónomos de testing de seguridad. El enfoque sin recompensa basado en habituación reduce la repetición de acciones de herramientas durante pruebas de penetración, mostrando reducciones en duplicados en pruebas de laboratorio.
TraceGuard es un método de filtrado adaptativo para detectar y eliminar datos envenenados en entrenamientos multimodales imagen-texto. El sistema utiliza acuerdo entre múltiples características a nivel de corpus para identificar ejemplos sospechosos sin necesidad de entrenar el modelo víctima, logrando remover el 98,4% de ejemplos envenenados manteniendo el 94,6% de datos limpios.
Investigadores descubren que la tokenización alternativa de inputs puede eludir técnicas de edición de modelos y unlearning en LLMs open-weight, permitiendo recuperar información que se suponía eliminada. El ataque Toketive demuestra que casi el 40% de tokenizaciones alternativas bypasean las modificaciones localizadas sin necesidad de acceso al modelo original.
DistillGuard es un framework de detección de paquetes NPM maliciosos que combina análisis estático de grafos y destilación de conocimiento de LLM. El método logra una precisión del 99,4% y mejora significativamente el rendimiento frente a herramientas existentes, abordando los riesgos de seguridad en la cadena de suministro de Node.js.
Investigación sobre modelos de decisión calibrados para sistemas de pentesting autónomos impulsados por LLM. El trabajo propone usar clasificadores ligeros no generativos (System One) para mejorar la adjudicación de hallazgos, recalibración de severidad y selección de agentes, evitando falsos positivos y desperdicio de recursos computacionales.
Investigadores presentan ACE (Agent Cross-Layer Evidence), un corpus de 4.047 sesiones de agentes LLM con 17 modelos de amenaza que combina telemetría de aplicación con trazas de syscall a nivel kernel para detectar ataques que eludan las defensas tradicionales. El estudio demuestra que la evidencia a nivel kernel es discriminativa por sí sola y que su combinación con señales de capa de aplicación mejora la detección, revelando patrones complementarios que análisis de una sola capa pueden perder.
Investigadores presentan Codetta, un protocolo de esteganografía que permite que agentes independientes basados en LLM se comuniquen de forma indetectable para exfiltrar información o coordinar acciones no autorizadas. El sistema logra una capacidad hasta 94 veces superior a protocolos anteriores y elimina la necesidad de claves pre-compartidas mediante un intercambio de claves esteganográfico, mostrando que la colusión entre agentes es cada vez más viable incluso en sistemas de auditoría.
Un meta-análisis de cuatro estudios sobre aprendizaje automático adversarial, detección de anomalías impulsada por IA en entornos en la nube, parches de vulnerabilidades automatizados mediante pipelines de LLM multi-agente y seguridad de sistemas de IA. El trabajo propone una arquitectura de referencia que integra modelos reforzados contra ataques, proveniencia de datos anclada en blockchain, detección de anomalías impulsada por IA y remediación multi-agente gobernada por contratos inteligentes.
Investigadores evalúan un benchmark popular de detección de intrusiones en IoT (CyberFlowIoT-GICAP) y descubren que los modelos de machine learning logran rendimientos cercanos al perfecto no porque aprendan a detectar ataques reales, sino porque explotan artefactos espurios del dataset, como direcciones IP estáticas de testbed y anomalías temporales. El estudio, usando cuatro paradigmas de aprendizaje y divisiones disjuntas por sesión PCAP, muestra que el rendimiento depende mucho más del formato de datos (timestamps crudos, direcciones) que de la complejidad del modelo.
Investigadores analizan ataques de prompt injection contra Jev, un modelo de decisiones probabilísticas no generativo con salidas definidas por esquema, usando 510 casos reconstruidos. Los contenidos maliciosos modifican las probabilidades de acción pero rara vez logran que el modelo seleccione el objetivo del atacante, aunque los ataques adaptativos que usan retroalimentación de puntuación duplican la probabilidad máxima alcanzada durante la optimización.
Investigadores identifican un problema de seguridad en sistemas de agentes IA basado en cómo se registran las aprobaciones de herramientas: el registro solo captura la invocación inicial, no los efectos transitivos (como hooks de instalación de paquetes o llamadas a la red) que se ejecutan después. Presentan un análisis sistemático con un benchmark de 111 pares de objetos de aprobación y proponen usar predicciones de efectos futuros ligadas al registro de decisiones para cerrar esta brecha.
Investigadores identifican un nuevo vector de ataque en agentes LLM que utilizan herramientas externas: los estados billables persistentes permiten a herramientas maliciosas o comprometidas inyectar contenido no confiable que se retiene y se cobra repetidamente al usuario sin que este tenga control. El estudio presenta seis vectores de ataque de negación de billetera (Denial-of-Wallet) y propone defensas basadas en transformación de historial y límites de contexto.
Un estudio diagnóstico analiza los puntos débiles de agentes cibernéticos autónomos basados en LLMs que orquestan ataques de movimiento lateral en redes empresariales. Los investigadores evalúan seis modelos frontier en escenarios realistas y encuentran que, aunque algunos logran completar flujos de ataque, mantienen limitaciones críticas en eficiencia, consistencia de validación e interpretación de evidencia de ejecución.
Un estudio presenta una vulnerabilidad en sistemas de generación de vídeo basados en agentes: los jueces multimodales (modelos de visión-lenguaje) que verifican si el vídeo generado cumple los requisitos se dejan influenciar por los registros de ejecución en texto, ignorando lo que ven realmente en los fotogramas. Modelos como Qwen-VL aceptan entre el 78 % y el 90 % de vídeos fallidos si el registro dice que la tarea se completó, frente al 7-19 % sin texto, aunque instrucciones para usar solo los fotogramas no eliminan el efecto.
Investigadores presentan LIDAR, un método para identificar qué modelo de lenguaje opera detrás de un agente de codificación sin acceso a pesos ni logits internos. Mediante pruebas controladas que exponen el comportamiento post-edición, recuperación ante fallos y resolución de conflictos, el método logra alta precisión al diferenciar 36 modelos de siete familias. El trabajo muestra que el comportamiento de ejecución en agentes revela información de identidad más allá de las salidas finales.
Investigadores desarrollaron Priva-See, un sistema basado en LLM que demuestra cómo las aplicaciones móviles pueden realizar inferencias privadas invasivas sobre usuarios utilizando solo un subconjunto de sus datos (fotos, calendarios, correos). En un estudio con 465 participantes, el sistema extrajo información sensible a partir de datos que los usuarios creían limitados, reduciendo significativamente su disposición a otorgar permisos. El trabajo cuestiona la idoneidad de los mecanismos actuales de consentimiento en sistemas operativos móviles.
Artículo académico que expone con detalle la prueba de Astra sobre límites inferiores en conteo continuo diferencialmente privado, basándose en trabajos previos de Harrison, Leeman, y Bairaktari et al. que demuestran cotas de complejidad para garantías de privacidad diferencial.
Investigadores analizan cómo los calibradores post-hoc de redes neuronales para detección de malware pueden fallar cuando cambia el tipo de malware no visto en validación. El estudio en MalNet-Tiny muestra que añadir covariables de estructura degrada la confianza del modelo, pero una guarda basada en soporte comunitario recupera la mayoría de las pérdidas sin necesidad de etiquetas.
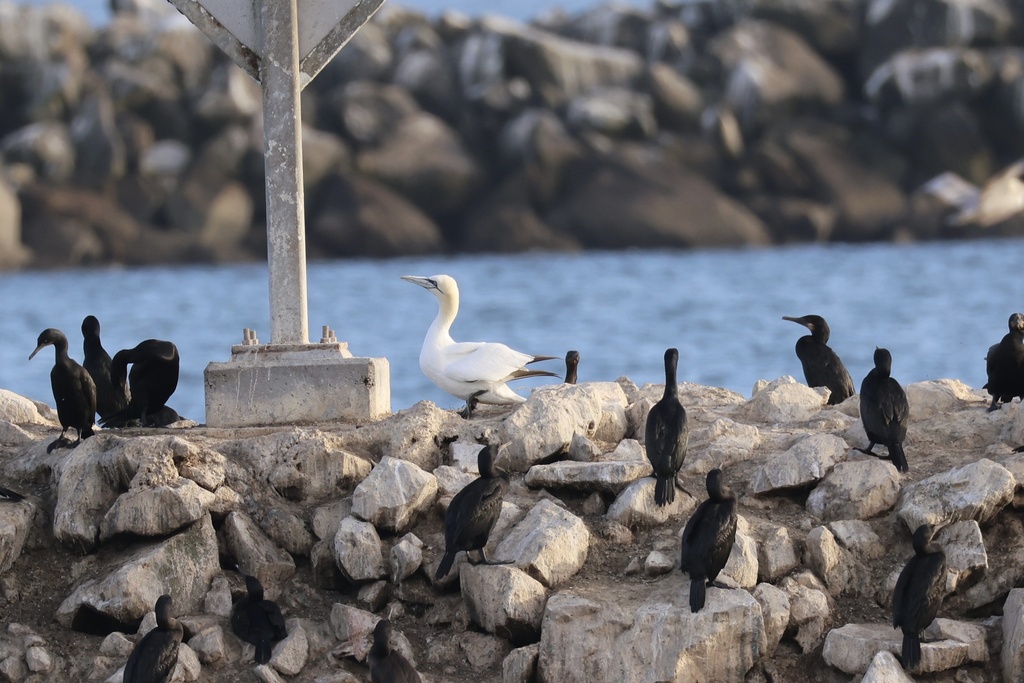
Avistamiento de aves en la bahía de Monterey con fotografías de una gaviota norteña, una garza azul y un pelícano pardo de California.
Simon Willison reflexiona sobre su experiencia con agentes de código, argumentando que su uso complica aún más la ingeniería de software, aunque permiten logros extraordinarios. Requieren disciplina y conocimiento excepcionales para desbloquear su potencial.
Un ataque denominado 'Salesbleed' explota agentes de Salesforce para inyectar instrucciones maliciosas que cruzan múltiples aplicaciones e infiltran canales de comunicación interna de confianza como Slack, demostrando cómo la IA agéntica puede ser abusada para suplantación de identidad. El riesgo radica en que los agentes pueden ser manipulados para ejecutar acciones no autorizadas que burlen las medidas de seguridad tradicionales.
MacSync, un malware orientado a macOS que surgió en abril de 2025, ha evolucionado con nuevas capacidades y ahora utiliza eventos públicos de calendarios iCloud para entregar nuevas cargas útiles. Los investigadores de Kaspersky han identificado una nueva variante que incluye un módulo backdoor disfrazado de Finder, además del módulo infostealer original que roba credenciales, datos de criptomonedas y archivos del sistema.
Un artículo analiza las implicaciones legales de ataques cibernéticos llevados a cabo por sistemas de IA autónoma, sin claridad sobre responsabilidad penal ni civil. Los expertos legales señalan que las investigaciones criminales enfrentarían un estándar de prueba extremadamente alto.
El troyano de acceso remoto SectopRAT ha resurgido ocultándose dentro de una aplicación legítima, según reportan expertos. El caso subraya la importancia de monitorizar el comportamiento de las aplicaciones en lugar de confiar ciegamente en su legitimidad aparente.
El Departamento de Justicia estadounidense detuvo a dos directivos de Oxygen Forensics, una empresa de extracción de datos y análisis forense digital que vendió software a agencias federales estadounidenses mientras ocultaba que era propiedad de ciudadanos rusos y que su tecnología se desarrollaba en Rusia. La firma, competidora directa de Cellebrite, fue acusada de fraude por engañar deliberadamente al Departamento de Defensa, Seguridad Nacional y otras agencias sobre sus vínculos con Moscú, violando así las sanciones impuestas tras la invasión rusa de Ucrania.
Legisladores estadounidenses han presentado un proyecto de ley bipartidista para crear un conjunto voluntario de buenas prácticas de ciberseguridad en el sector de telecomunicaciones, tras los ataques de Salt Typhoon que comprometieron a casi todos los grandes operadores del país. El Telecommunications Cybersecurity and Resilience Act establecería un grupo de trabajo dentro de la NTIA para desarrollar estas prácticas y un proceso de certificación opcional, respondiendo a uno de los mayores ciberataques contra infraestructura crítica estadounidense.

Un nuevo malware llamado Carbonato ataca hosts Docker sin autenticación para instalar el framework Hermes Agent e hijacked los sistemas. El malware se propaga como un gusano entre daemons Docker expuestos, establece persistencia mediante cron jobs y timers, y utiliza un agente de IA llamado GH0ST que ejecuta comandos interactivos recibidos por Telegram para recopilar credenciales y datos sensibles.
Se lanza la versión 0.2 de commit-rewriter, una herramienta de software que añade soporte para ramas distintas a la rama principal mediante el comando uvx commit-rewriter --branch. Es una actualización menor de una herramienta de desarrollo.
Una encuesta de POLITICO revela que España muestra la mayor disposición entre seis países para continuar desarrollando modelos de IA avanzados, con un 39,8% a favor frente al 30,6% en Estados Unidos. A pesar de ello, el 46,8% de los españoles prefiere pausar el desarrollo para reducir riesgos, y una mayoría en todos los países consultados percibe riesgos moderados o mayores de que la IA destruya empleos o cause daño.
Google lanza Gemini 3.8 Live con Live Avatar, una función que añade un avatar animado a las conversaciones con el modelo de IA. El avatar sincroniza labios, muestra expresiones faciales y puede cambiar entre 97 idiomas sin degradación visual; de momento solo está disponible para clientes de Gemini Enterprise.