Tenemos un nuevo modelo capaz de pasar el test de Turing en vídeo. O al menos eso dicen sus creadores
Xataka IA · 2 oct, 20:31
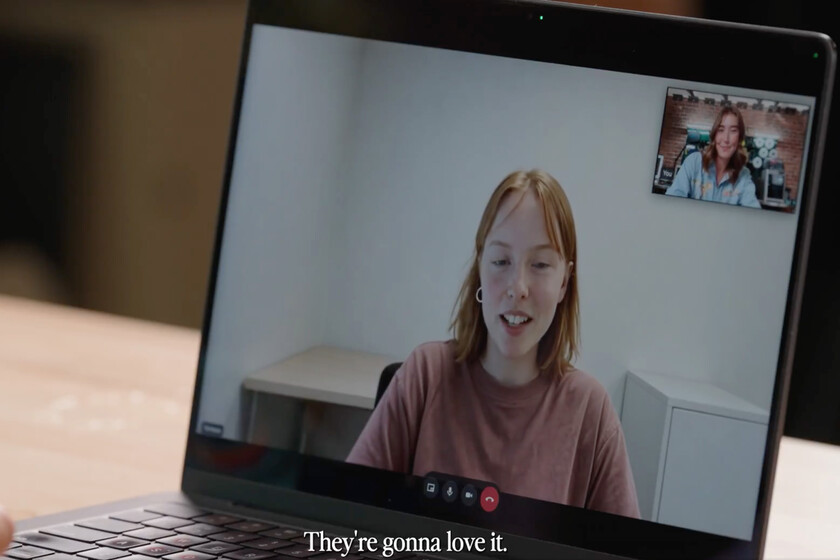
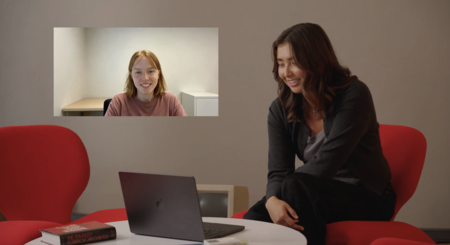
Tavus ha presentado Griffin-Lite, un modelo de IA capaz de mantener videollamadas interactivas en tiempo real que genera rostro, voz y respuestas de forma simultánea. En un experimento con 54 participantes, el 48% creyó estar hablando con una persona real tras una conversación de un minuto, lo que la empresa presenta como el primer modelo que «supera un test de Turing en vídeo». Sin embargo, el concepto difiere significativamente del test de Turing clásico y no existe un protocolo único reconocido para esta variante audiovisual.
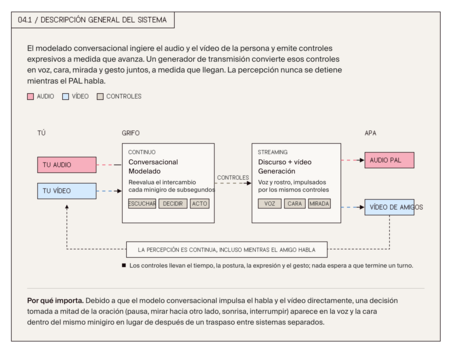
Griffin-Lite funciona como un modelo full-duplex que escucha, observa y reacciona continuamente en intervalos menores a un segundo, permitiendo gestos naturales como asentimientos, interpretación de pausas e interrupciones. La generación de voz, rostro, mirada y gestos proviene de las mismas decisiones conversacionales, lo que proporciona coherencia audiovisual.
El contexto es importante: el test de Turing original de 1950 se basaba en comunicación escrita sin pistas físicas, y no existe un protocolo único reconocido como «test de Turing en vídeo». Un estudio en PNAS de mayo de 2026 mostró que GPT-4.5 con instrucciones de personalidad fue identificado como humano el 73% de las veces en conversaciones escritas simultáneas de cinco minutos. En el benchmark VideoFDB de NVIDIA (237 fragmentos reales), Griffin-Lite puntuó 3,73 en percepción frente a 4,20 de referencia humana, y 3,83 en generación frente a 3,92 humana. La versión actual es solo de investigación para testers seleccionados; Tavus planea una versión más potente más adelante.
Puntos clave
- Griffin-Lite es un modelo full-duplex que genera voz, rostro y respuestas simultáneamente mientras escucha y observa
- El 48% de 54 participantes creyó hablar con una persona real tras un minuto de conversación
- El experimento difiere del test de Turing clásico (escrito, sin pistas visuales) y no sigue un protocolo único establecido
- En VideoFDB de NVIDIA, Griffin-Lite alcanza 3,73 sobre 4,20 en percepción (referencia humana)
- La versión actual es solo de investigación; aún no está disponible para clientes comerciales de Tavus
Figuras de la fuente