Apertus 1.5 Release Notes
Hugging Face Blog · 15 oct, 11:08

Swiss AI lanza Apertus 1.5, una versión mejorada de su modelo de lenguaje abierto disponible en tamaños de 8 mil y 70 mil millones de parámetros. La nueva versión incorpora comprensión multimodal nativa (imágenes y audio), un modo de razonamiento mejorado, contexto extendido hasta 262.144 tokens, y mejoras en el seguimiento de instrucciones y uso de herramientas, manteniendo los pesos, datos y detalles de entrenamiento completamente abiertos.
Apertus 1.5 es una continuación del entrenamiento del modelo de primera generación, añadiendo 4 billones de tokens de texto e datos multimodales para el modelo de 8B y 2 billones para el de 70B. La multimodalidad se introduce mediante una aproximación de fusión temprana, donde imágenes y audio se tokenizan directamente en la misma secuencia que el texto, utilizando el tokenizador Emu3.5 para imágenes (512×512 se convierten en 1.024 tokens) y WavTokenizer para audio (40 tokens por segundo), sin cambiar la arquitectura del modelo.
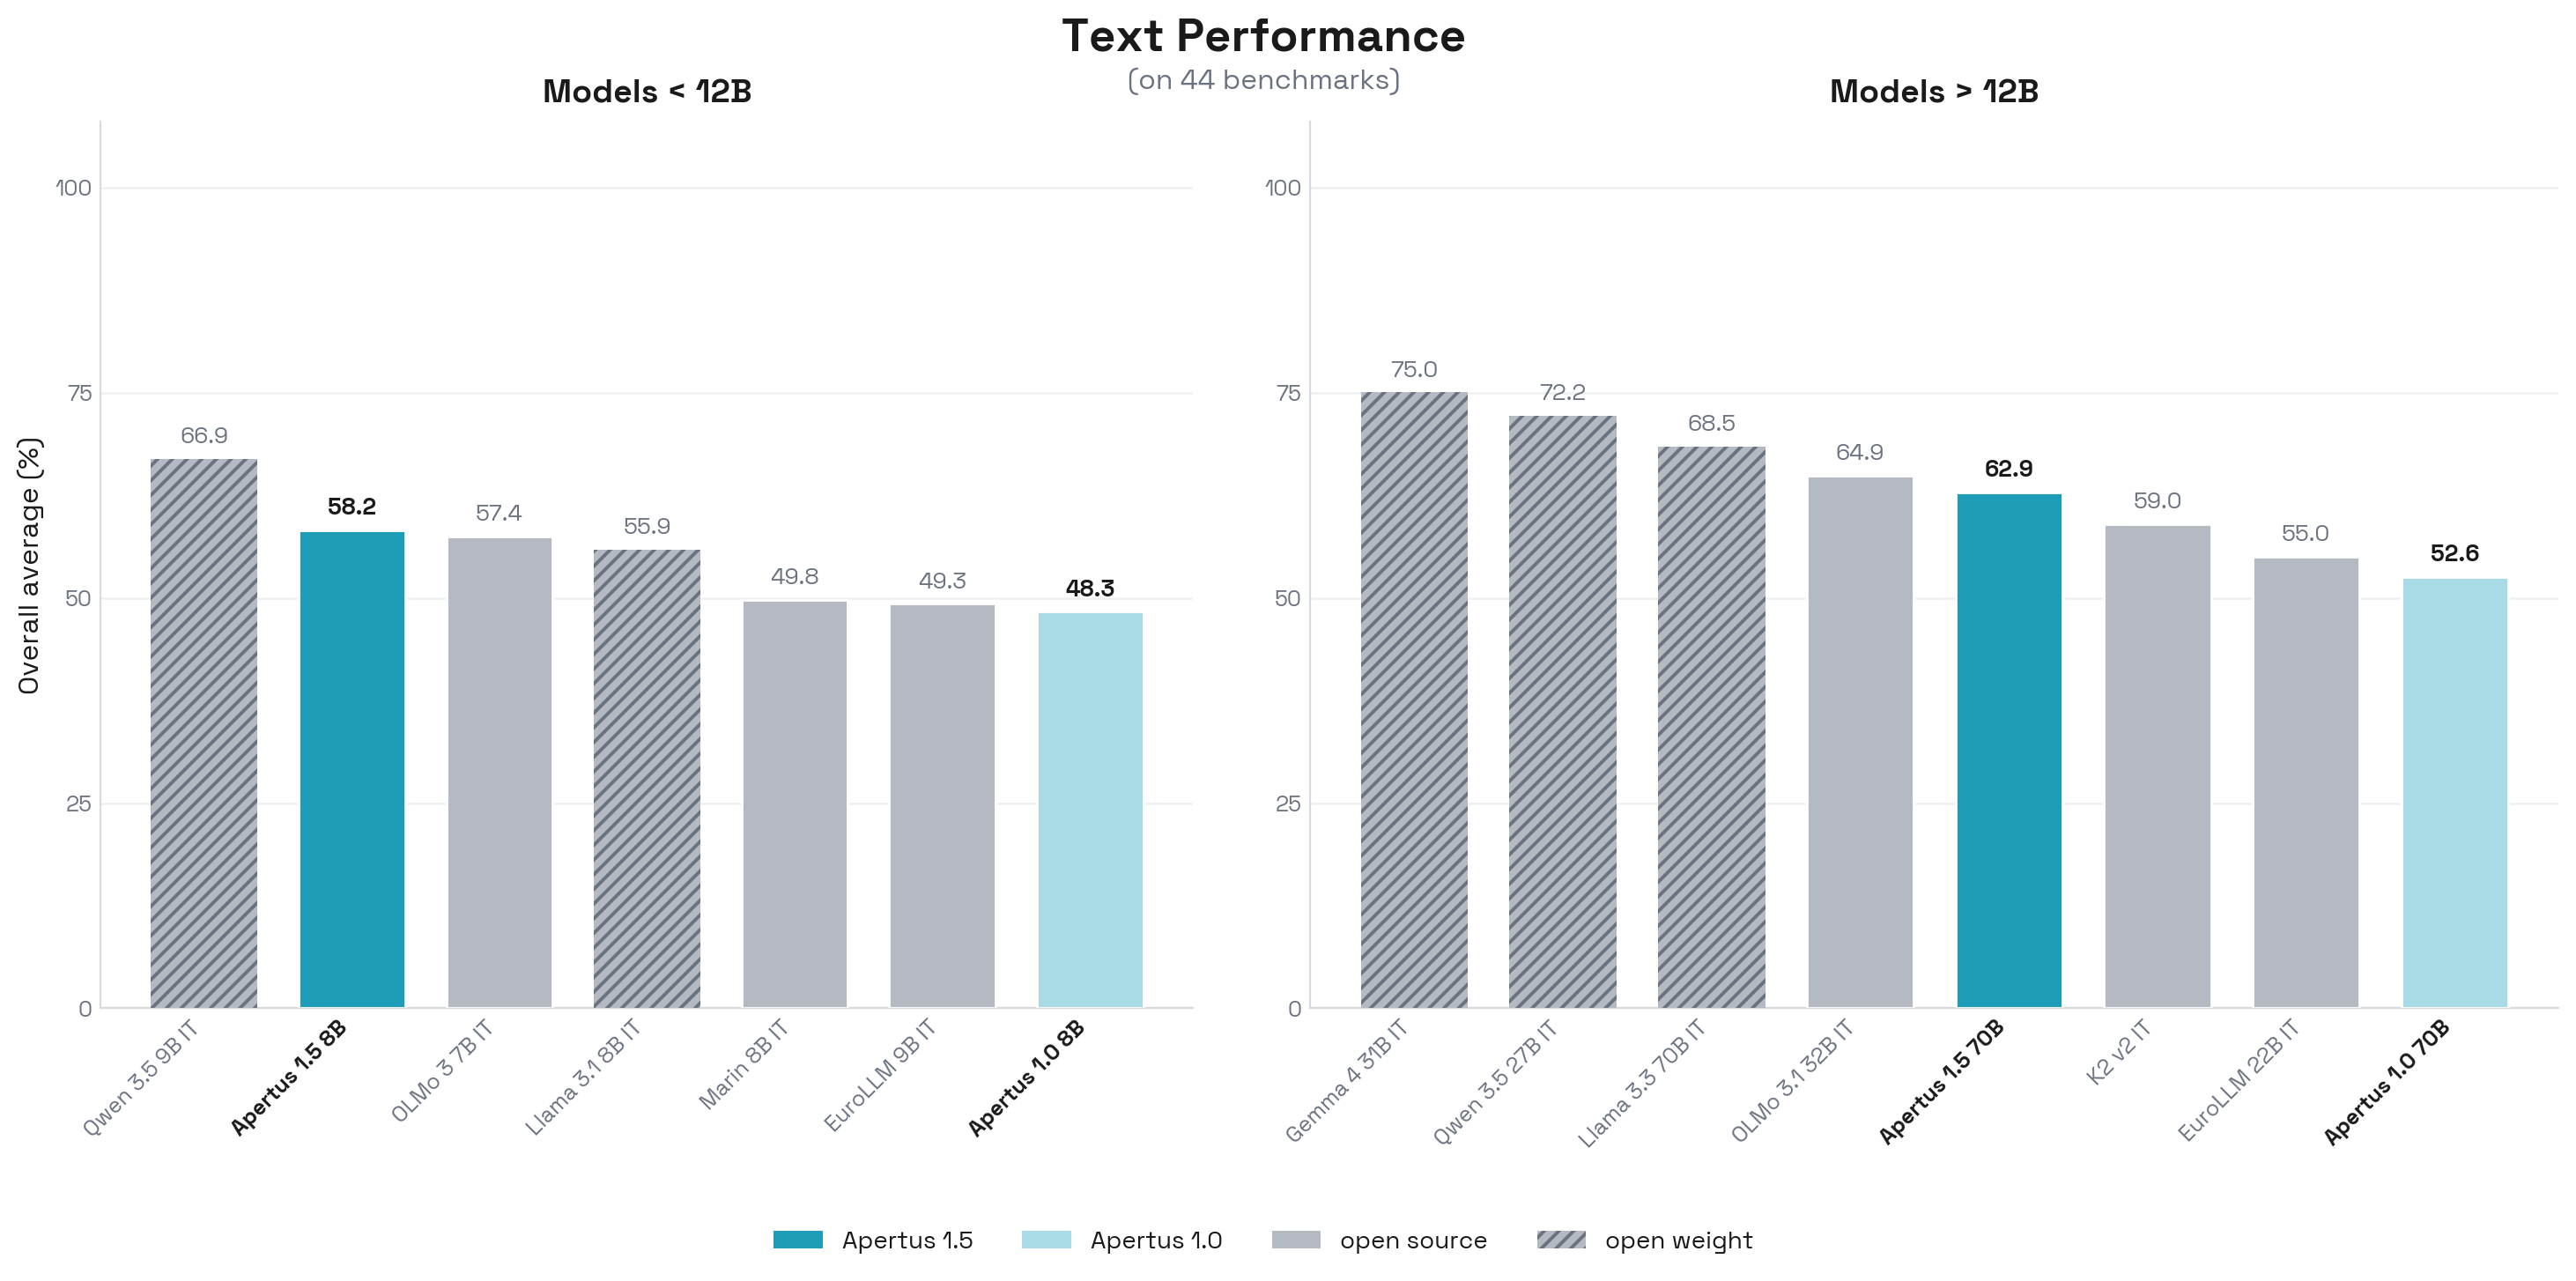
El proceso de post-entrenamiento comprende cinco etapas: SFT sobre 3,7 millones de muestras, SFT para contexto largo a 262k tokens, RL con recompensas verificables (RLVR) en aproximadamente 350k prompts, DPO con pares de preferencias puntuadas y SDPO para alineación con la Carta de Apertus. En evaluaciones, el modelo 8B supera a modelos abiertos de tamaño similar en tareas de seguimiento de instrucciones y multilingüismo, y muestra rendimiento competitivo en comprensión espacial y de documentos entre modelos abiertos.
Puntos clave
- Tamaños: 8B y 70B parámetros con contexto de 262.144 tokens
- Multimodalidad nativa: imágenes, audio y procesamiento de lenguaje hablado
- Modo de razonamiento para problemas complejos
- Entrenamiento totalmente abierto: pesos, datos e instrucciones publicados
- Rendimiento competitivo en traducción automática y tareas legales suizas
Figuras de la fuente